KI im Büro - Die Datenschutz-Sperrliste für dein Team
Die Frage kommt in fast jedem Erstgespräch, meistens spät und leiser als alle anderen. Und in der Hälfte der Fälle folgt derselbe Nachsatz: Wir machen das ja schon, ich weiß nur nicht, ob wir dürfen. Genau darum geht es in diesem Beitrag — welche Daten bei dir nie rausgehen dürfen, welche unbedenklich sind, und welche Frage du dir vor der Tool-Frage stellen musst.
VIDEO HIER:
Welche Daten dürfen in ChatGPT und Claude — und welche nie?
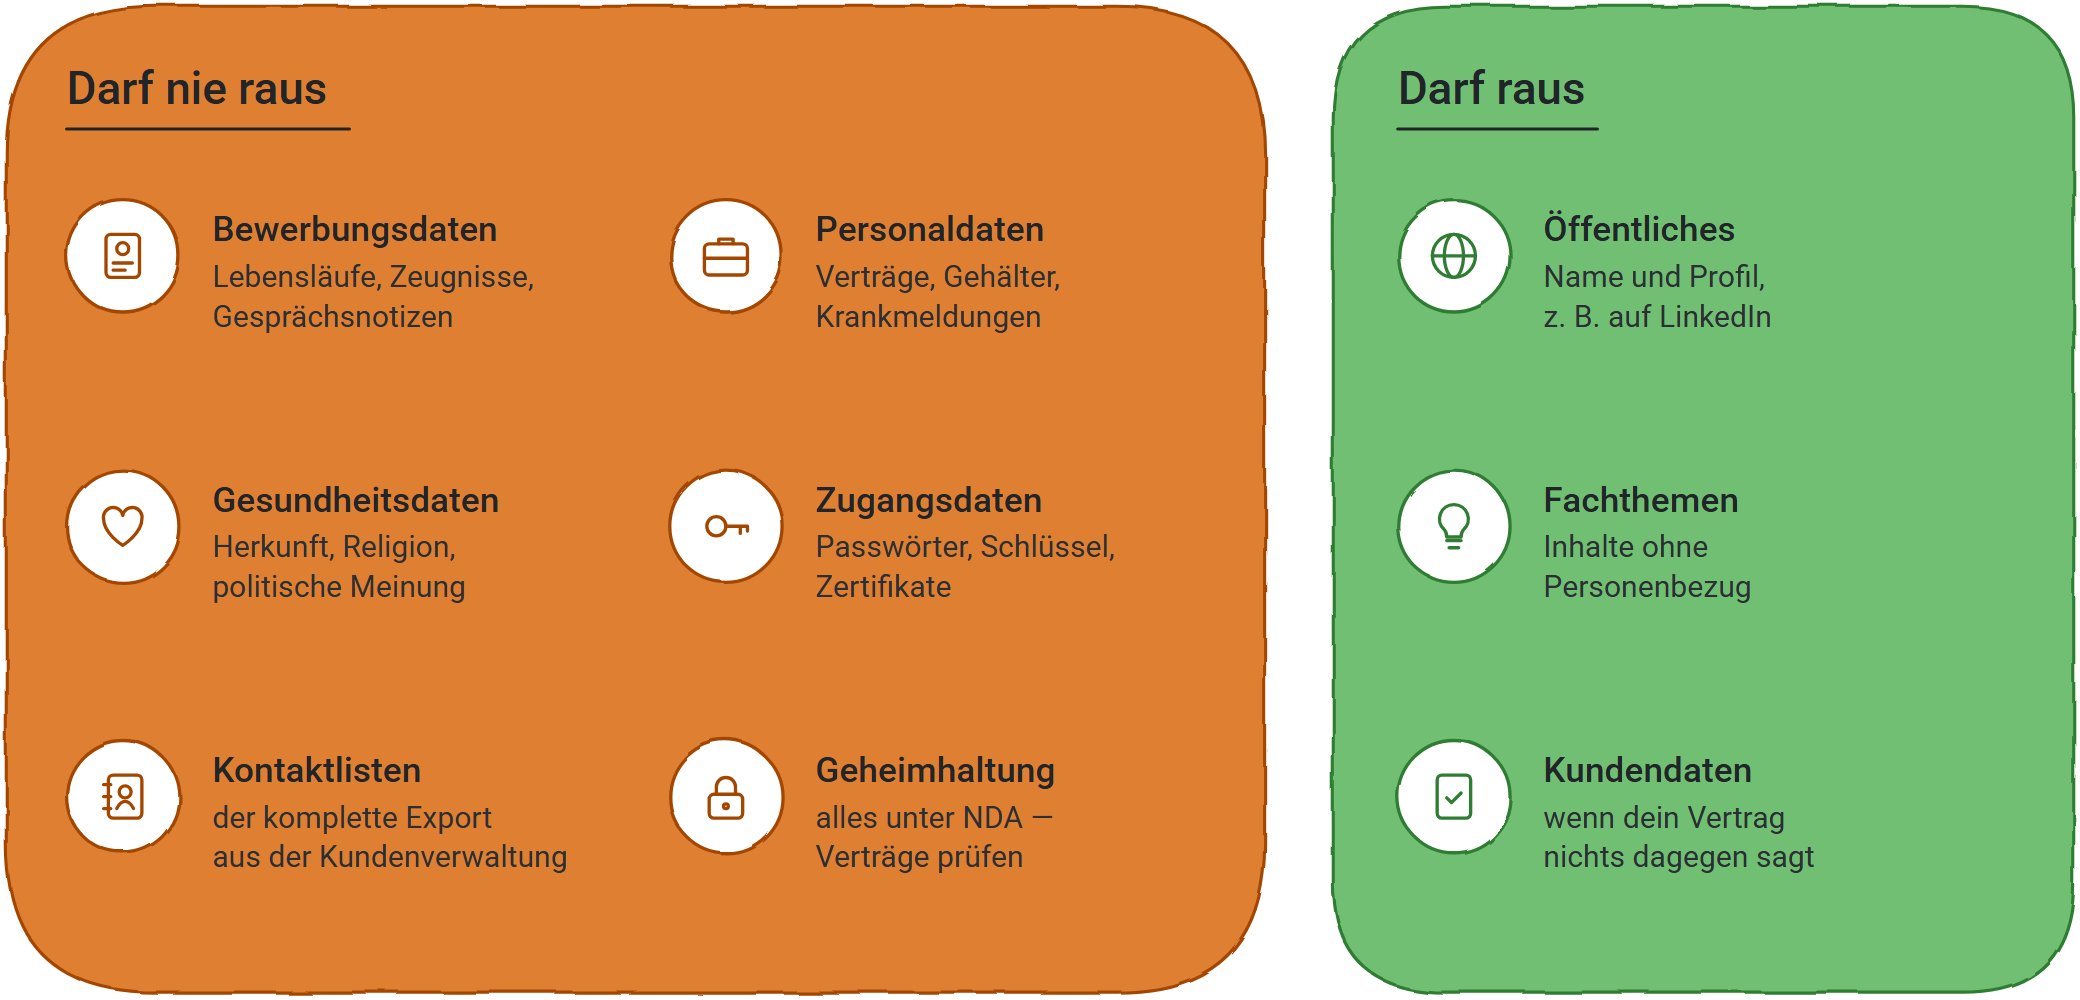
In ChatGPT oder Claude darfst du alles eingeben, was ohnehin öffentlich ist, und alle Inhalte ohne Personenbezug; mit Kundendaten lässt sich arbeiten, solange deine Verträge nichts Gegenteiliges festlegen. Nie hinein gehören sechs Kategorien: Bewerbungsdaten, Personaldaten, Gesundheitsdaten und andere geschützte Kategorien, Zugangsdaten, vollständige Kontaktlisten und alles, was unter einer Geheimhaltungsvereinbarung steht.
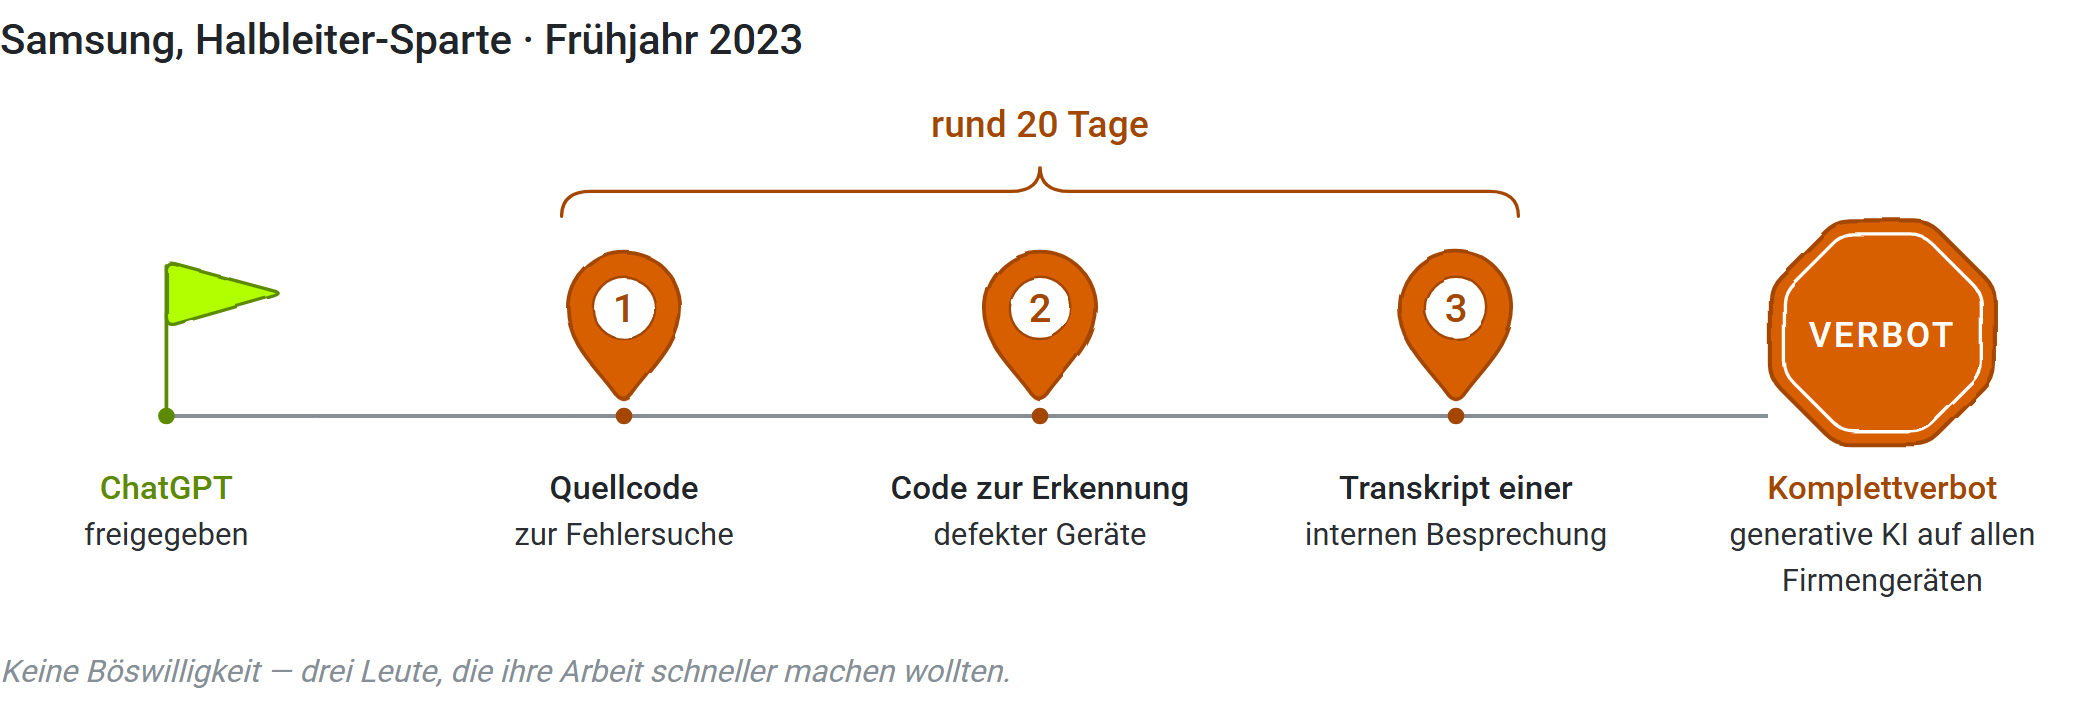
Wie schnell es ohne Regel schiefgeht, zeigt Samsung: Im Frühjahr 2023 landeten in rund 20 Tagen dreimal vertrauliche Daten im Chatfenster, danach kam ein Komplettverbot. Der Denkfehler dahinter ist die Reihenfolge: Die meisten fragen zuerst, welches Tool datenschutzkonform ist, statt festzulegen, welche Daten überhaupt raus dürfen.
Im Ingenieur- und Planungsbüro wiegt das doppelt, weil Objektdaten und Vertraulichkeitsklauseln direkt am nächsten Auftrag hängen.
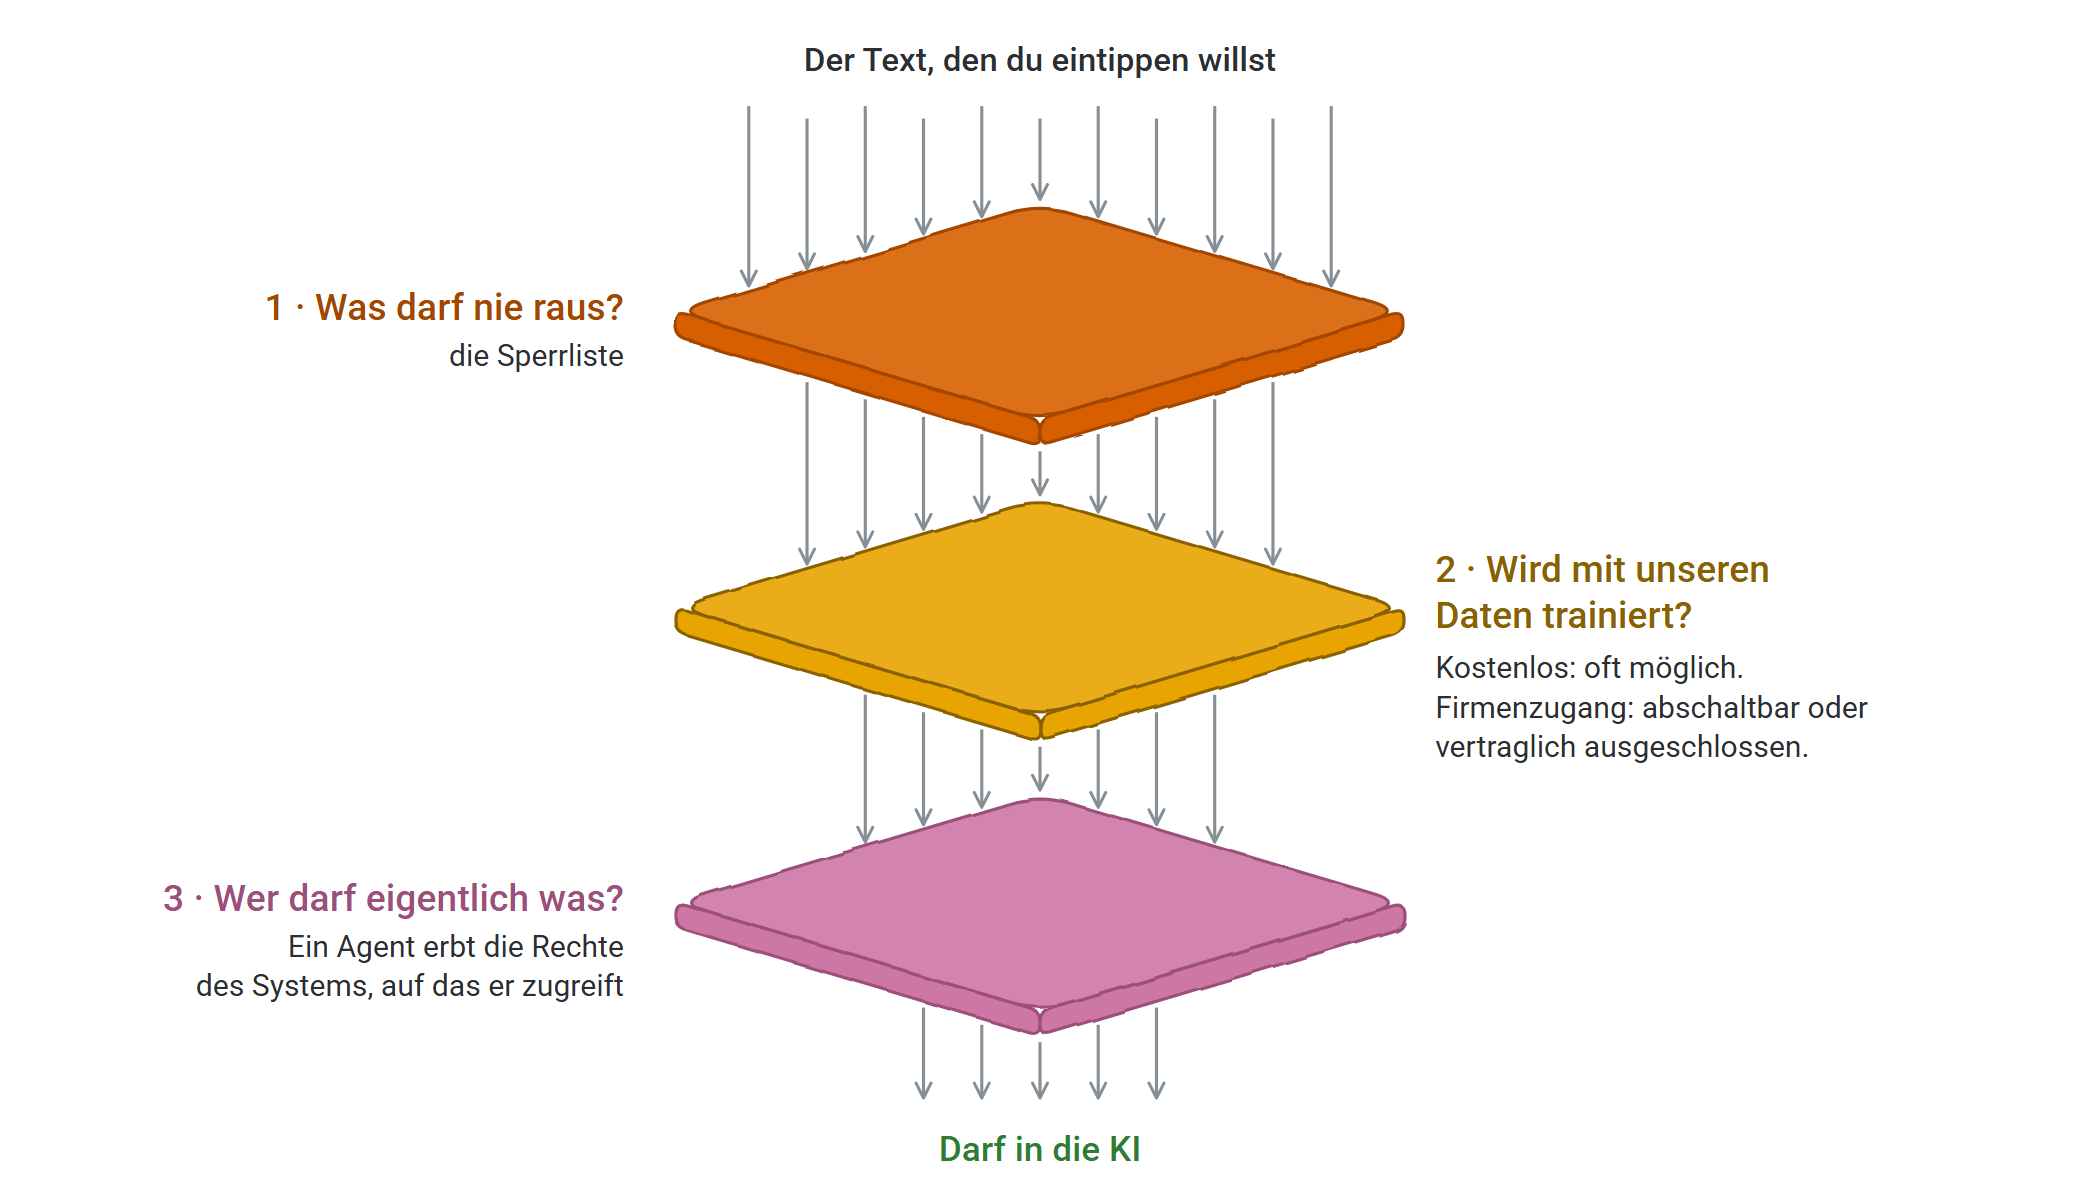
Vor dem ersten Eintippen stehen deshalb drei Fragen: Was darf nie raus? Wird mit unseren Daten trainiert? Wer darf eigentlich was?
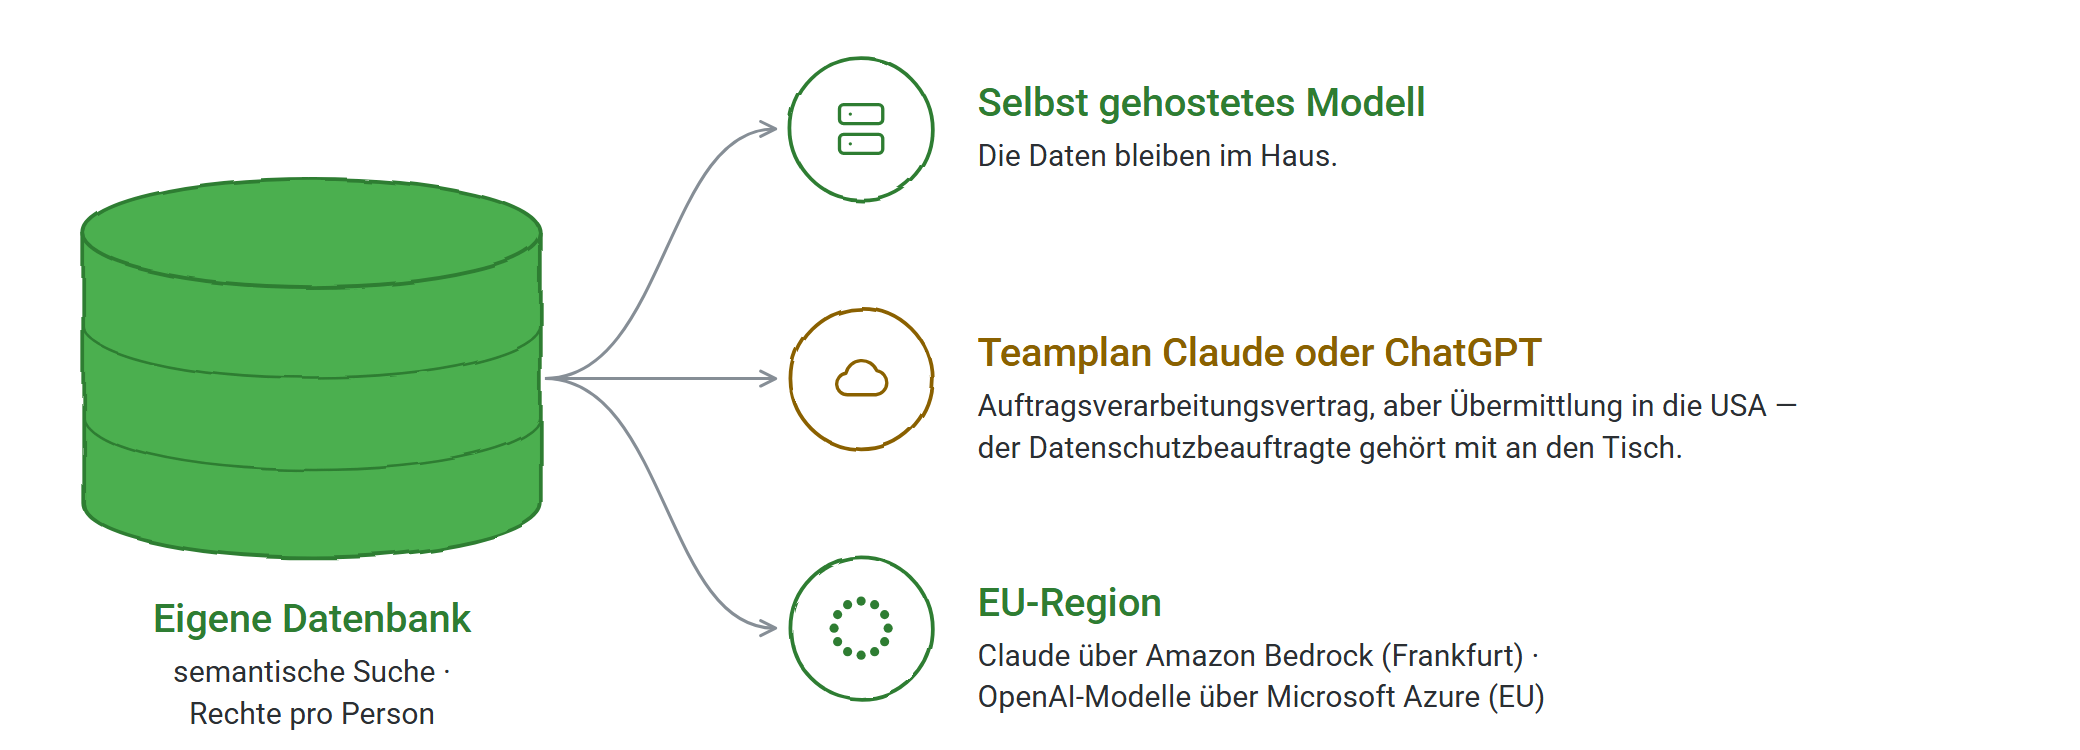
Datensammlungen gehören in eine eigene Datenbank mit Zugriffsrechten pro Person; Claude und ChatGPT lassen sich über den Teamplan mit Auftragsverarbeitungsvertrag einbinden oder, wenn Daten Deutschland nicht verlassen dürfen, über Amazon Bedrock in Frankfurt beziehungsweise Microsoft Azure in europäischen Rechenzentren.
Für den Alltag reicht eine Faustregel: Was du keinem externen Dienstleister ohne Vertrag geben würdest, gehört nicht in die KI.
Ein Hinweis vorweg, den Shabi auch im Video ausdrücklich macht: Das ist eine Betriebssicht aus der eigenen Praxis, keine Rechtsberatung. Für den konkreten Fall gehört ein Datenschutzbeauftragter oder ein Rechtsberater mit an den Tisch.
Was bei Samsung passiert ist
Frühjahr 2023, Samsung, Halbleiter-Sparte — also genau der Teil des Konzerns, in dem die wertvollsten Betriebsgeheimnisse der Branche liegen. Die Ingenieure hatten gerade die Erlaubnis bekommen, ChatGPT zu nutzen, mit dem Ziel, produktiver zu werden.
Innerhalb von rund 20 Tagen passierte dreimal dasselbe. Ein Ingenieur kopierte internen Quellcode aus der Halbleiterdiagnose in das Chatfenster, weil er einen Fehler suchte. Ein zweiter lud Code hoch, um defekte Geräte zu identifizieren. Ein dritter gab das Transkript einer vertraulichen internen Besprechung ein, weil er sich daraus ein Protokoll machen lassen wollte.
Keine Böswilligkeit, kein Leichtsinn im eigentlichen Sinne. Drei Leute, die ihre Arbeit schneller machen wollten. Die Reaktion des Konzerns war ein Komplettverbot generativer KI auf allen Firmengeräten, verschickt als internes Memo.
Drei Vorfälle in rund 20 Tagen — danach kam das Komplettverbot.
Der Fall ist aus zwei Gründen lehrreich:
Erstens: Wenn es Samsungs Ingenieuren passiert, passiert es jedem Team. Nicht weil die Leute schlechter wären, sondern weil das Muster überall gleich ist — das Werkzeug ist da, die Regel fehlt, also entscheidet jeder selbst. Und unter Zeitdruck entscheidet jeder großzügig. Zweitens: Das Verbot ist eine konsequente Antwort, aber sie kostet genau die Produktivität, um die es eigentlich geht.
Der Denkfehler: Tool-Frage vor Daten-Frage
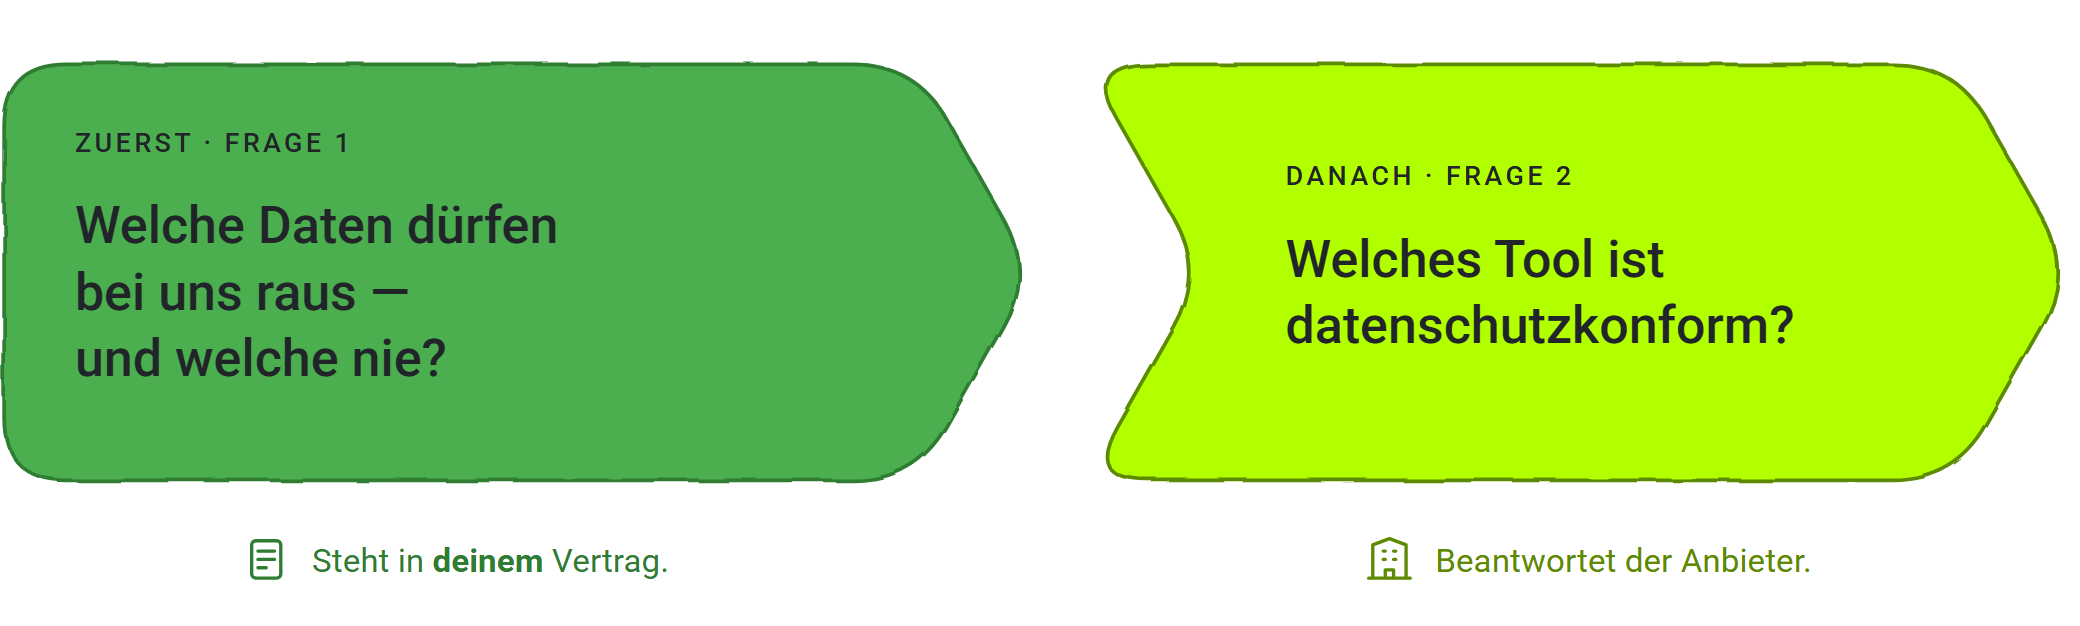
Die erste Frage, die sich fast alle stellen, lautet: Welches Tool ist datenschutzkonform? Das ist die zweite Frage. Die erste ist: Welche Daten dürfen bei uns überhaupt raus, und welche nie?
Erst die Regel, dann das Tool.
Wer bei der Tool-Frage anfängt, delegiert eine Entscheidung an einen Anbieter, die nur er selbst treffen kann. Der Anbieter sagt dir, was sein System technisch macht. Er sagt dir nicht, ob die Unterlagen deines Industriekunden da hinein dürfen — das steht in deinem Vertrag, nicht in seinem.
Und solange die Regel fehlt, entscheidet jeder Mitarbeiter für sich. Fünf Leute, fünf Regeln: Der eine ist übervorsichtig und nutzt gar nichts, der andere lädt die komplette Ausschreibung hoch. Formal hat keiner von beiden etwas falsch gemacht, weil nie definiert wurde, was richtig ist.
Warum es im technischen Büro schärfer ist
Wenn in einer Werbeagentur jemand einen Text in ein Chatfenster kippt, ist das meistens nur ein Text — keine personenbezogenen Daten, nichts Sicherheitsrelevantes. Im Ingenieur- oder Planungsbüro sieht das anders aus.
Dort geht es um Auftraggeberdaten mit Namen, Ansprechpartnern und Konditionen. Um Objektdaten wie Adresse, Grundriss und Anlagenbestand, die teilweise sicherheitsrelevant sind: Bei manchen Objekten will niemand, dass außerhalb des Büros steht, wie die Zutrittstechnik aufgebaut ist, wie das Gebäude aufgeteilt ist und wer rein- und rauskommt. Dazu kommen Verträge mit Vertraulichkeitsklauseln, die bei Industriekunden, Investoren und Betreibern eher die Regel als die Ausnahme sind, und öffentliche Auftraggeber mit eigenen Spielregeln.
Und dann gibt es einen Punkt, der in der Datenschutzdiskussion fast immer untergeht: Im technischen Büro ist der Betrieb selbst die Referenz. Wenn beim Auftraggeber der Eindruck entsteht, seine Objektdaten seien irgendwo gelandet, wo sie nicht hingehören, ist das kein Datenschutzthema mehr — es ist ein Auftragsthema. Der nächste Rahmenvertrag geht woanders hin, und man erfährt nicht einmal, warum.
Die Sperrliste: sechs Punkte, die nie raus dürfen
Diese Liste stammt aus der KI-Nutzungsrichtlinie von HOSH MEDIA. Sie ist als Vorlage gedacht — was am Ende auf der eigenen Liste steht, entscheidet jeder Betrieb selbst.
Bewerbungsdaten. Lebensläufe, Anschreiben, Zeugnisse, Gesprächsnotizen. „Fass mir die drei Bewerber zusammen“ klingt praktisch, ist aber der Bereich mit dem geringsten Spielraum.
Personaldaten. Arbeitsverträge, Gehälter, Krankmeldungen, Abmahnungen, Beurteilungen. Alles, was zwischen Arbeitgeber und Mitarbeiter steht.
Gesundheitsdaten und geschützte Kategorien. Herkunft, Religion, politische Meinung. Hier gibt es keinen Ermessensspielraum.
Zugangsdaten. Passwörter, Schlüssel, Zertifikate. Sollte selbstverständlich sein — die Samsung-Ingenieure zeigen, dass es das nicht ist.
Vollständige Kontaktlisten. Der Export aus der Kundenverwaltung. „Sortier mir das mal eben schnell“ ist ein verständlicher Impuls und trotzdem ein Nein.
Alles unter Geheimhaltungsvereinbarung. Dafür müssen die eigenen Verträge einmal insgesamt durchgegangen werden.
Und was darf raus?
Alles, was ohnehin öffentlich ist: Vor- und Nachname, die auf LinkedIn stehen, ein Profil, das jeder nachlesen kann.
Dazu alle inhaltlichen Themen ohne Personenbezug. Und wenn in den eigenen Verträgen nichts Gegenteiliges festgelegt ist, lässt sich auch mit Kundendaten arbeiten.
Die Sperrliste als Vorlage — was auf deiner Liste steht, entscheidest du.
Die drei Fragen vor dem ersten Eintippen
Frage eins: Was darf nie raus?
Das ist die Sperrliste oben. Ohne sie ist alles Weitere Glückssache.
Frage zwei: Wird mit unseren Daten trainiert?
Hier zählt der Unterschied zwischen einem kostenlosen Konto und einem Firmenzugang zum ersten Mal wirklich. Bei vielen kostenlosen Zugängen kann das, was eingegeben wird, zur Verbesserung des Systems weiterverwendet werden. Bei betrieblichen Zugängen lässt sich das in der Regel abschalten oder ist vertraglich ausgeschlossen.
Frage drei: Wer darf eigentlich was?
Ohne Festlegung entsteht Schattennutzung — jeder hat sein eigenes Konto, keiner redet darüber, und man erfährt davon erst, wenn etwas schiefgeht.
Ein einfaches Beispiel: Darf ein Mitarbeiter sehen, was die Geschäftsführung verdient? Sobald ein Agent Zugriff auf ein System bekommt, erbt er dessen Rechte. Deshalb gehört vorher auf eine Liste, welche Systeme freigegeben sind und wer mit dem Agenten worauf zugreifen darf.
Drei Fragen, bevor jemand im Team das erste Mal etwas eintippt.
Wohin die Daten stattdessen gehören
Der Vorschlag aus der Praxis: Datensammlungen gehören in eine eigene Datenbank, nicht zu externen KI-Anbietern.
Mit semantischer Suche, damit Inhalte auch wirklich gefunden werden, und mit Zugriffsrechten pro Person.
Steht diese Datenbank sauber strukturiert im eigenen Haus, ist es zweitrangig, ob ein selbst gehostetes Modell darauf arbeitet oder ob gezielt einzelne Bereiche an Claude oder ChatGPT gegeben werden.
Beide lassen sich datenschutzkonform einführen: Über den Teamplan gibt es bei beiden Anbietern einen Auftragsverarbeitungsvertrag. Trotzdem findet auch dort eine Übermittlung in die USA statt, also in ein Drittland — spätestens hier gehört der Datenschutzbeauftragte mit an den Tisch.
Für Fälle, in denen Daten Deutschland gar nicht verlassen dürfen, gibt es Umwege: Die Claude-Modelle lassen sich über Amazon Bedrock aus der Region Frankfurt betreiben, für die OpenAI-Modelle gibt es den gleichen Weg über Microsoft Azure in europäischen Rechenzentren.
Erst die eigene Datenbank, dann die Wahl des Modells. Beim Teamplan gehört der Datenschutzbeauftragte mit an den Tisch.
Die Faustregel für zwei Sekunden
Wenn aus diesem Thema nur ein Satz hängen bleiben soll, dann dieser. Er steht so in der Richtlinie:
Das kann jeder im Büro in zwei Sekunden beantworten — ohne Schulung, ohne Nachschlagen.
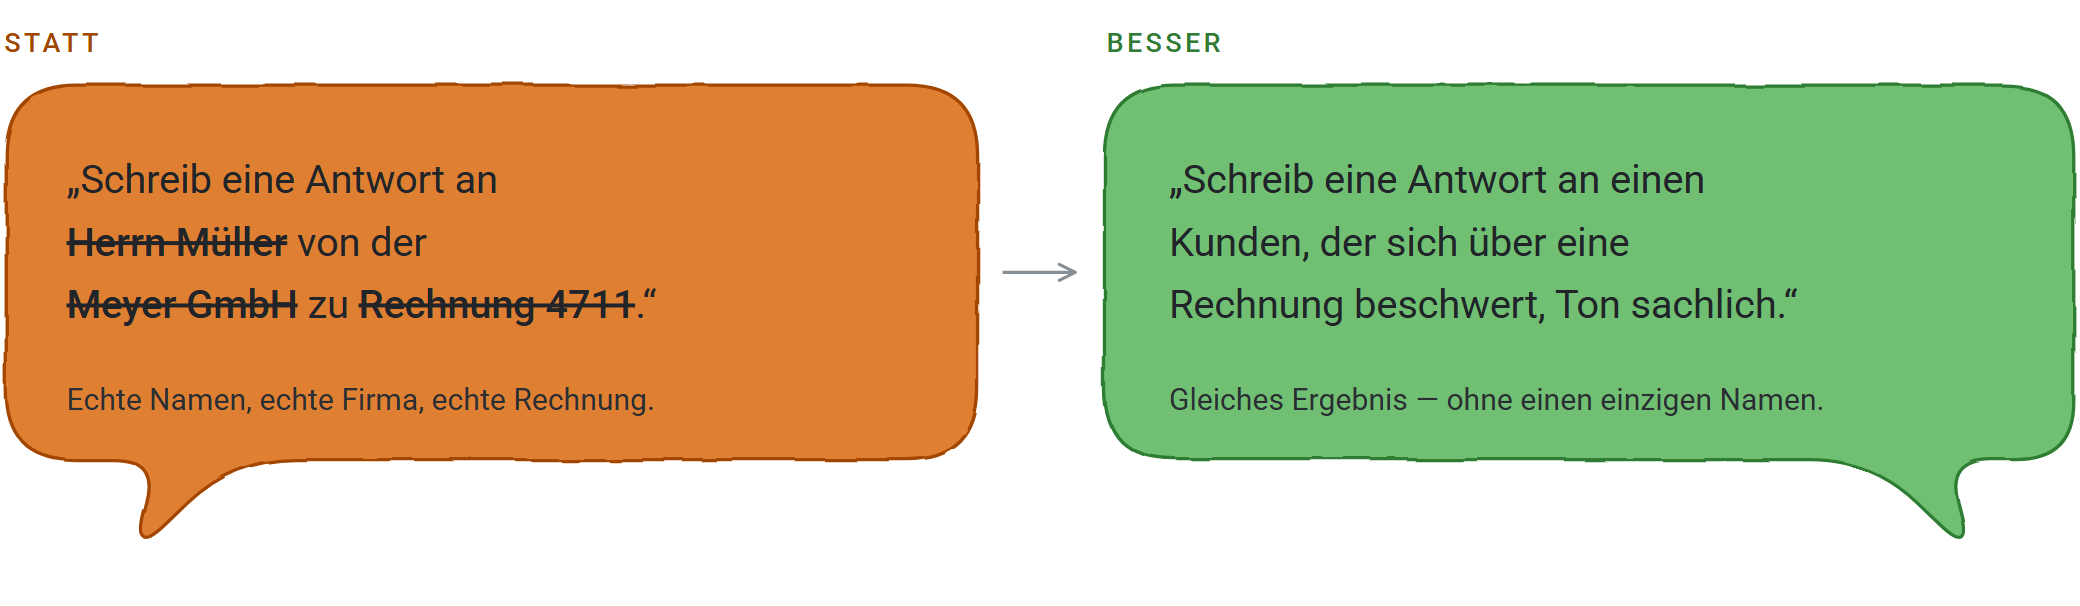
Und der zweite Griff ist noch praktischer, weil das System die echten Namen meistens gar nicht braucht. Statt „Schreib eine Antwort an Herrn Müller von der Meyer GmbH zu Rechnung 4711“ reicht „Schreib eine Antwort an einen Kunden, der sich über eine Rechnung beschwert, Ton sachlich“.
Das Ergebnis ist genauso gut, der Aufwand sind zwei Sekunden, und das Problem ist weg.
Das System braucht die echten Namen meistens gar nicht.
Über das Video hinaus
Die folgenden Punkte werden im Video nicht behandelt — sie ergänzen es für die Umsetzung.
Wie eine Sperrliste im Alltag überlebt. Eine Liste, die in einem Ordner liegt, wird nicht gelesen. In der Praxis funktioniert sie, wenn sie eine Seite lang ist, an der Wand hängt oder im Intranet auf der Startseite steht, und wenn sie beim Onboarding einmal durchgesprochen wird. Wer sie auf drei Seiten schreibt, hat sie faktisch nicht.
Der Unterschied zwischen „abschalten“ und „ausgeschlossen“. Bei Frage zwei lohnt es sich, genau hinzuschauen: Eine Einstellung, die man abschalten kann, kann auch jemand wieder einschalten. Vertraglich ausgeschlossen ist die stärkere Variante. Beim Prüfen der Anbieter also nicht nur fragen, ob es geht, sondern wo es steht.
Warum die Bestandsaufnahme zuerst kommt. Bevor eine Regel geschrieben wird, lohnt eine schlichte Runde im Team: Wer nutzt gerade welches System für die Arbeit? Ohne Vorwurf, rein als Bestandsaufnahme. Das Ergebnis überrascht die meisten Geschäftsführungen — und es zeigt, welche Punkte auf der Sperrliste überhaupt gebraucht werden.
Fazit
Die Frage „Welches Tool ist datenschutzkonform?“ lässt sich nicht sinnvoll beantworten, solange die Frage davor offen ist: Welche Daten dürfen bei uns raus und welche nie?
Erst die Regel, dann das Tool.
Alles andere heißt, eine Entscheidung an einen Anbieter zu delegieren, der den eigenen Kundenvertrag nicht kennt.